

L’automatisation de la R&D recompose la course aux modèles d’IA
Les laboratoires ne cherchent plus seulement à produire des modèles plus performants : ils les intègrent à leur propre appareil de recherche. Cette boucle peut accélérer la compétition technologique, tout en faisant du contrôle humain une ressource rare.
La compétition entre laboratoires d’intelligence artificielle entre dans une phase moins visible que la publication d’un nouveau modèle, mais potentiellement plus déterminante : l’intégration des modèles à la chaîne qui les conçoit, les évalue et les entraîne. L’enjeu n’est plus seulement de disposer du meilleur système à un instant donné. Il est d’augmenter la vitesse à laquelle un laboratoire peut produire la génération suivante.
Anthropic affirme que l’automatisation de la R&D représente désormais 26 % de ses activités de recherche en IA conduites au niveau dit « AI leads ». Selon les indicateurs publiés par l’entreprise, cette part était inférieure à 1 % en février. À ce stade, un salarié formule un objectif, vérifie les résultats et conserve la responsabilité de la validation ; l’agent Claude exécute l’essentiel du travail intermédiaire. Cette mesure reste une déclaration de l’entreprise et ne constitue pas, à elle seule, un audit indépendant de ses capacités.
Mais elle renseigne une transformation concrète de l’appareil productif des grands laboratoires. Les agents ne sont plus seulement proposés aux entreprises clientes pour coder, rédiger ou analyser des documents. Ils deviennent des instruments internes d’expérimentation : revue de littérature, conception de protocoles, écriture et correction de code, analyse des métriques, optimisation d’infrastructures et préparation de tests.
L’automatisation de la R&D devient un avantage industriel
La nouveauté ne réside pas dans l’usage de logiciels pour assister les chercheurs. Les méthodes d’apprentissage profond avaient déjà réduit l’intervention humaine dans la sélection manuelle des variables pertinentes. Avec l’automatisation de la R&D, la délégation remonte d’un cran : l’IA peut recevoir une tâche complexe, la décomposer, produire plusieurs essais et soumettre ses résultats à une supervision humaine.
Anthropic décrit cinq degrés d’autonomie. Le niveau le plus élevé supposerait qu’un système détecte lui-même un problème, formule une piste de recherche, réalise les tests, les évalue et déploie le résultat sans intervention humaine. L’entreprise indique n’avoir aucune activité classée à ce niveau. En revanche, elle estime que plus de 90 % de ses travaux de R&D relèvent au moins du niveau de « collaborateur IA », où des blocs substantiels de travail sont réalisés sous une direction humaine rapprochée.
Dans sa publication consacrée aux indicateurs de développement interne, Anthropic avance que près de 30 000 agents de recherche peuvent travailler simultanément sur sa plateforme, en communiquant et en se répartissant des sous-tâches. L’ordre de grandeur importe davantage que le chiffre exact : un laboratoire capable de paralléliser des milliers d’expériences dispose d’un levier que ne reproduisent ni une simple hausse des effectifs ni l’achat de quelques licences de logiciels.
Si la trajectoire interne observée par Anthropic se poursuivait, l’entreprise estime que les tâches conduites au niveau « AI leads » pourraient approcher 80 % de sa R&D d’ici la fin de l’année. Cette projection ne préjuge pas de la qualité des résultats. L’autonomie d’exécution ne garantit ni la pertinence scientifique, ni l’originalité des hypothèses, ni la robustesse des évaluations. Elle raccourcit néanmoins le temps séparant une idée d’un essai mesurable.
Le calcul et la supervision, deux goulets d’étranglement
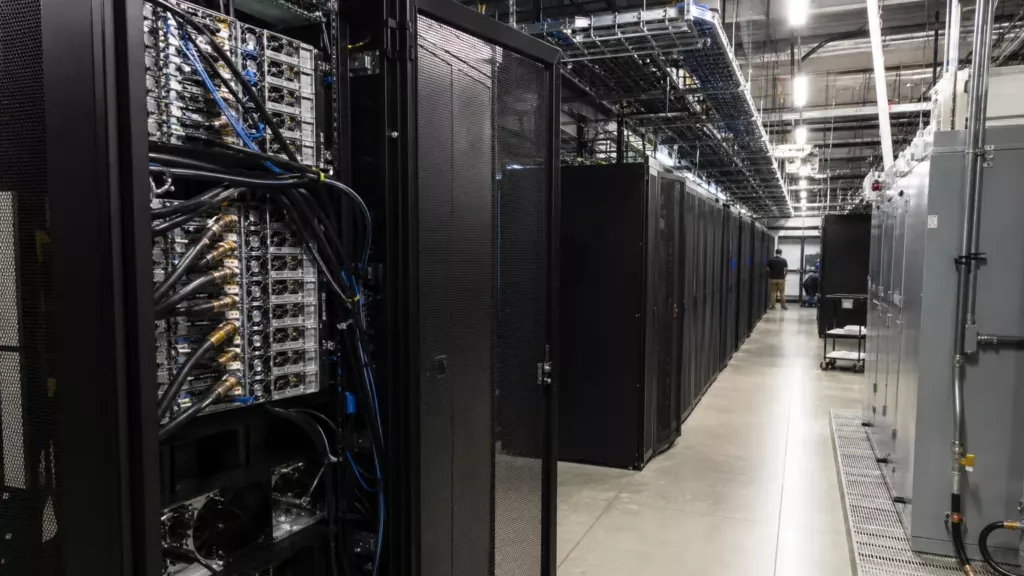
L’automatisation de la R&D ne rend pas la recherche immatérielle. Au contraire, elle rend plus centrale l’infrastructure physique : accélérateurs, réseaux, énergie, capacités de stockage et accès aux fonderies. Multiplier les agents implique de multiplier les inférences et les évaluations. Dans ce modèle, l’avantage ne dépend pas uniquement des données et des algorithmes, mais de la faculté à réserver durablement du calcul à un coût soutenable.
Cette contrainte explique le rapprochement entre les laboratoires et les concepteurs de puces. OpenAI a indiqué avoir conçu avec Broadcom une puce d’inférence, Jalapeño, et avoir ramené à neuf mois le passage de la conception initiale à l’envoi en fonderie. L’entreprise attribue une partie de cette compression à l’usage de ses propres modèles dans les étapes de conception et d’optimisation. Le cycle de l’IA se referme ainsi sur lui-même : des modèles accélèrent la mise au point des infrastructures nécessaires pour entraîner et faire fonctionner les modèles suivants.
La Chine suit la même logique d’intégration. Zhipu AI a annoncé avoir utilisé un agent fondé sur GLM-5.3 pour optimiser la couche d’inférence de son modèle suivant sur des puces Huawei. L’entreprise a fait état d’un triplement du débit sur 10 000 puces en moins de deux semaines. Ces données, publiées par les acteurs concernés, ne permettent pas une comparaison directe entre architectures. Elles illustrent toutefois une pression commune : tirer davantage de performances d’un parc de calcul disponible, surtout lorsque l’accès aux composants les plus avancés est contraint.
Le second goulet est humain. Plus les agents proposent, exécutent et évaluent des expériences, plus la fonction de supervision devient stratégique. Il faut choisir les objectifs, détecter les résultats aberrants, prévenir les optimisations trompeuses et décider à quel moment une modification peut être intégrée dans un modèle de production. Une supervision superficielle peut transformer un gain de vitesse local en dette technique ou en risque de sécurité à grande échelle.
La sécurité reste minoritaire dans l’allocation du calcul
Anthropic propose de suivre trois indicateurs : la part de l’automatisation de la R&D, la capacité des humains à superviser les agents et la répartition des ressources de calcul. Leur intérêt est de convertir une notion souvent abstraite — la capacité d’un modèle à contribuer à l’amélioration de son successeur — en variables observables. Ils pourraient aussi fournir aux régulateurs des seuils de discussion plus concrets que les seules annonces de performances.
La publication souligne cependant une asymétrie. Sur une semaine observée, environ 6 % du calcul mobilisé pour la R&D en IA aurait été consacré à des travaux de sécurité. La proportion ne dit rien, à elle seule, de l’efficacité des équipes chargées de ces sujets. Elle montre en revanche que l’essentiel des ressources demeure orienté vers la progression des capacités et des produits.
Pour les puissances publiques, le sujet relève désormais de la souveraineté technologique autant que de la régulation numérique. Celui qui maîtrise les puces, l’électricité, les centres de données et les équipes capables d’évaluer des agents autonomes peut accélérer son cycle d’innovation. L’Europe ne peut donc réduire la question à l’accès à des assistants conversationnels. La véritable dépendance se situe dans l’infrastructure et dans les méthodes qui permettent aux modèles de participer, de façon encadrée ou non, à leur propre développement.
